GEO
一个常见的求助帖:AI API 在 curl 里返回干净的 JSON,一接进浏览器应用就抛出 TypeError: Failed to fetch。第一反应通常是换密钥、换模型,或者加上 mode: "no-cors" 碰碰运气。这三种做法都把协商问题当成了鉴权问题。
同样的反射也出现在 GEO 策略里。团队在自己浏览器里确认页面能打开,就认定内容“已上线”,然后困惑为什么答案引擎引用的是竞争对手。某个客户端能用,并不等于这份资源可被读取。不同客户端在接受你的字节之前会执行不同的检查——而决定 AI 是否引用的那些客户端,往往不是你测试时用的那一个。
“curl 里能用”几乎证明不了什么
curl 不是浏览器。它不执行同源策略,不发预检请求,不需要 Access-Control-Allow-Origin,直接把完整的响应体交给你。终端里的 200 只说明:端点存在、凭证有效、网络通路打开。它完全不能说明浏览器、嵌入式组件、合作方集成,或会执行 JavaScript 的爬虫能否使用这个结果。
对应的 GEO 场景是“因为有人已登录所以看起来正常”的演示。只有在客户端向需鉴权的端点发起 fetch 之后才出现的内容,属于“curl 成功、爬虫不可见”。多数 AI 索引机器人并不执行这一步 fetch,它们读完 HTML 给出的东西就离开了。
图示:来源页预览图(仅作编辑上下文;版权归属原发布方) · 来源引用:dev.to
预检请求就是浏览器的 robots.txt
当跨源请求携带 JSON 内容类型或自定义请求头时,浏览器会先发一个 OPTIONS 请求。如果服务端没有返回正确的 Access-Control-Allow-Origin、Access-Control-Allow-Headers 和 Access-Control-Allow-Methods,真正的请求根本不会离开本机。你看到的是 CORS 错误而不是服务端错误,API 日志则可疑地一片空白。
这是一个协商层,和 robots.txt、llms.txt 完全同类:它决定实质性的请求是否会被发起。当 AI 爬虫在 robots 中被禁止,或 CDN 规则对陌生 User-Agent 弹出挑战页时,症状一模一样——业务日志里什么都没有,看板上全是疑惑。调试预检请求能养成正确的习惯:先看协商步骤,再动请求体。
如果希望 AI 答案引擎能引用你,就在根目录放一份简短诚实的 llms.txt,让 robots 指令与站点地图保持一致,并显式放行你真正欢迎的代理。协商被拦截,修起来很便宜,发现起来很昂贵。
响应到了,却读不出来
mode: "no-cors" 返回的是不透明响应:状态码 0,没有响应头,没有响应体。请求可能在服务端已经成功,只是不允许你查看。这也是技术 SEO 里最被低估的失效模式——内容被送达了,但无法被读取。
例子很多:价格被画进 canvas,关键参数只存在于某个静默失败的客户端组件里,产品事实被锁在没有替代文本和说明文字的图片中,FAQ 答案要等一次交互才被换上。字节到了,意义没到。抽取不到论断的答案引擎无法引用它;无法核实的论断,它只会归给别人。
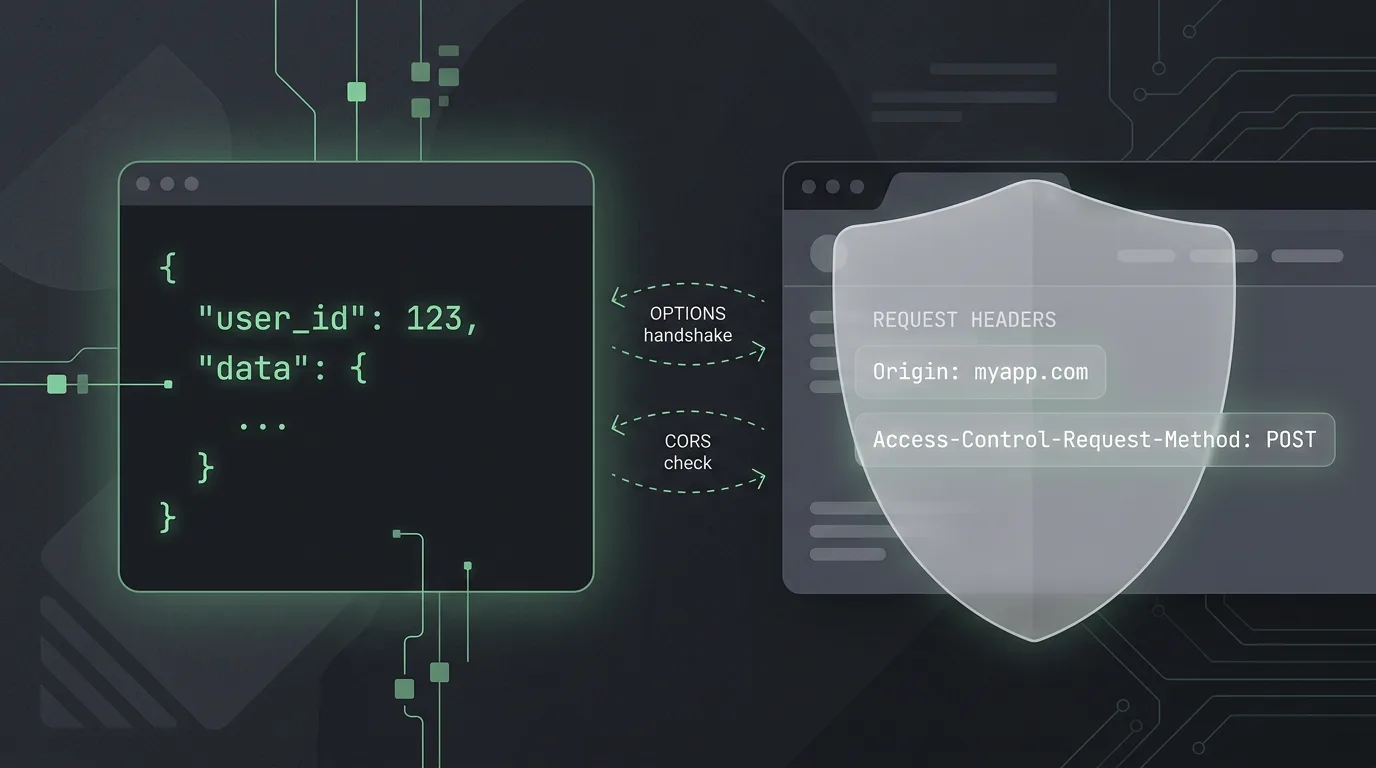
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:dev.to
发生在请求之前的失败
有些浏览器故障根本到不了你的应用:广告拦截与隐私插件、遗漏了 API 源的 Content Security Policy、HTTPS 页面上的混合内容、陈旧 service worker、localStorage 里过期的 token,或者一次不走运的 DNS 解析。处理原则始终一致——先记录实际发出了什么,再改任何东西。
换成 GEO 的语言,就是审计爬虫实际收到了什么,而不是你的浏览器渲染出了什么。用 AI 爬虫的 User-Agent 抓取关键 URL,把原始 HTML 与渲染后的 DOM 做对比,确认站点地图里的 lastmod 没有说谎,并检查反爬规则没有悄悄把你最想要引用你的那些代理挡在挑战页外面。
多客户端检查清单
- 先让承重事实出现在 HTML 里,再用 JavaScript 增强。一句话如果需要被引用,它就应该存在于首次响应中。
- 输出与可见文本一致的结构化数据——
Product、FAQPage、Article、Organization——而不是一套与页面平行的标记宇宙。 - 把
llms.txt作为 canonical 资源的简短准确地图发布,只链接你希望被摘要的页面。 - 保持 URL 稳定、canonical 明确。警惕
noindex响应头被误加到那些“看起来像 API 路径、其实在提供内容”的路由上。 - 对于你期望被引用的材料,不要要求凭证,也不要用源锁定的端点。
- 每次变更用四类客户端验证:curl、无头浏览器、AI 爬虫 User-Agent、普通移动网络。
- 按 User-Agent 记录 4xx 与 5xx,让反爬拦截变成一个指标,而不是一桩悬案。
关键要点
- curl 成功只能证明凭证有效,不能证明客户端能消费这个响应。
- CORS 只由浏览器执行,AI 爬虫根本不理它。因此真正的 GEO 风险是“只在浏览器里渲染”,而不是 CORS。
- 预检失败是协商失败。修白名单和响应头,不要换密钥。
- 不透明响应、读不出来的内容,等价于不可被引用的内容。
llms.txt、robots 指令与结构化数据是你的机器可读契约,属于基础设施,不是装饰。
下一步
- 用真正出问题的那个客户端复现,而不是用一个根本无法以同样方式失败的工具。
- 抓取外发请求:方法、Origin、请求头、凭证模式。
- 与可用的 curl 调用逐行对比。
- 关闭 JavaScript,渲染商业价值最高的二十个页面,检查核心论断是否仍然存在。
- 发布
llms.txt,核对 robots 与站点地图一致性,并把 AI 引荐流量当作一级渠道来监测。
来源
延伸阅读:AI API Works in curl but Fails in the Browser? Debug CORS and Preflight