AI
每次做 AI 功能复盘,第一反应往往是换更便宜的模型或者把提示词砍短。这是最贵的解法。生产系统里的钱通常不是从定价里漏掉的,而是从冗余里漏掉的:四十个人点了同一个按钮,同一份摘要就被生成了四十次;一篇热门文章在三十秒内被五十个用户点了「总结」,后端就并发打出五十个上游请求,每一个都付全价,每一个都在等最慢的那个 token。
服务商层面的提示词缓存(OpenAI 的自动前缀缓存、Anthropic 的显式 cache_control 断点)确实能复用重复的前缀,但它不会在应用层对完整的相同请求做去重,也完全解决不了并发洪峰。这两件事是你自己的问题,而且几百行代码就能解决。
把下面这份清单当作任何高并发 LLM 路由上线前的闸门。每一项都有「通过」与「不通过」的判定标准。最后统计你的通过数。
第一部分 — 确定性的请求指纹
图示:来源页预览图(仅作编辑上下文;版权归属原发布方) · 来源引用:dev.to
如果两个逻辑上完全相同的请求可以算出两个不同的缓存键,后面所有环节都失去意义。确定性是地基。
1.1 规范化序列化。 请求载荷必须经过规范化序列化器,而不是对手工拼装的对象直接 JSON.stringify。
- 通过:键的顺序被规范化,语义上与顺序无关的数组被排序,空白被裁剪,生成的字符串在不同进程、不同发布版本之间逐字节一致。
- 不通过:某个依赖升级后对象属性顺序变了,你的键就变了,命中率悄悄归零。
1.2 哈希完整的请求元组,而不是只哈希用户消息。 哈希输入必须包含模型 ID、系统提示词、temperature、top_p、top_k、max_tokens、停止序列、工具/函数 schema、响应格式,以及(若支持)seed。
- 通过:把 temperature 从 0.2 改成 0.9,键随之改变。
- 不通过:只哈希用户内容,于是本该高创造性的调用被喂回确定性的缓存答案——这是伪装成省钱的正確性缺陷。
1.3 隔离租户与权限范围。 在键的命名空间里包含工作区或组织 ID。
- 通过:两个租户提交同样的问题,绝不会共享同一条缓存。
- 不通过:跨租户命中——那是数据泄露,不是优化。
1.4 给提示词与 schema 打版本号。 把提示词版本号和工具 schema 版本写进键里。
- 通过:一次发布中修改系统提示词,会生成干净的缓存命名空间,旧条目自然过期。
- 不通过:你上线了提示词修复,用户却继续拿到昨天的行为,而且无法解释。
1.5 隔离易变输入。 时间戳、请求 ID、会话 token、随机种子一旦进入提示词,命中率就完了。
- 通过:你要么把易变值粗粒度分桶(用日期而非毫秒),要么把它从键中剥离,要么有意识地接受该路由命中率接近零。
- 不通过:系统提示词里有个
current_time字段,意味着每个请求都独一无二,缓存纯属装饰。
第二部分 — 缓存里到底存什么
2.1 存拼装完成的最终结果,而不是流式分片。 落盘的内容应包括最终文本、finish_reason、模型版本、token 用量,以及可能存在的工具调用轨迹。
- 通过:命中时可以合成一条流回放给客户端,UI 契约不变。
- 不通过:你缓存了原始 SSE 帧,回放时任何期待特定分片结构的客户端都会崩。
2.2 绝不缓存错误、拒答和截断输出。
- 通过:上游 429、超时以及
finish_reason: length的响应绕过写入路径。 - 不通过:一次短暂的服务商故障被钉进缓存整整一个 TTL,所有用户都看到同一次失败。
2.3 TTL 按内容易变性设定,而不是一个全局值。 工单分类可以存活数小时;新闻摘要应该在几分钟内过期。
- 通过:TTL 按路由配置,且有书面理由。
- 不通过:统一 24 小时默认值,导致时效性路由给出陈旧答案,稳定路由又浪费存储。
2.4 给存储设上限并定义淘汰策略。
- 通过:条目数与字节数都有上限,采用 LRU 或 TTL 清扫策略,且能观测到淘汰速率。
- 不通过:内存里一张无界 map,一直涨到进程重启。
第三部分 — 在途请求合并(Single-Flight)
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:dev.to
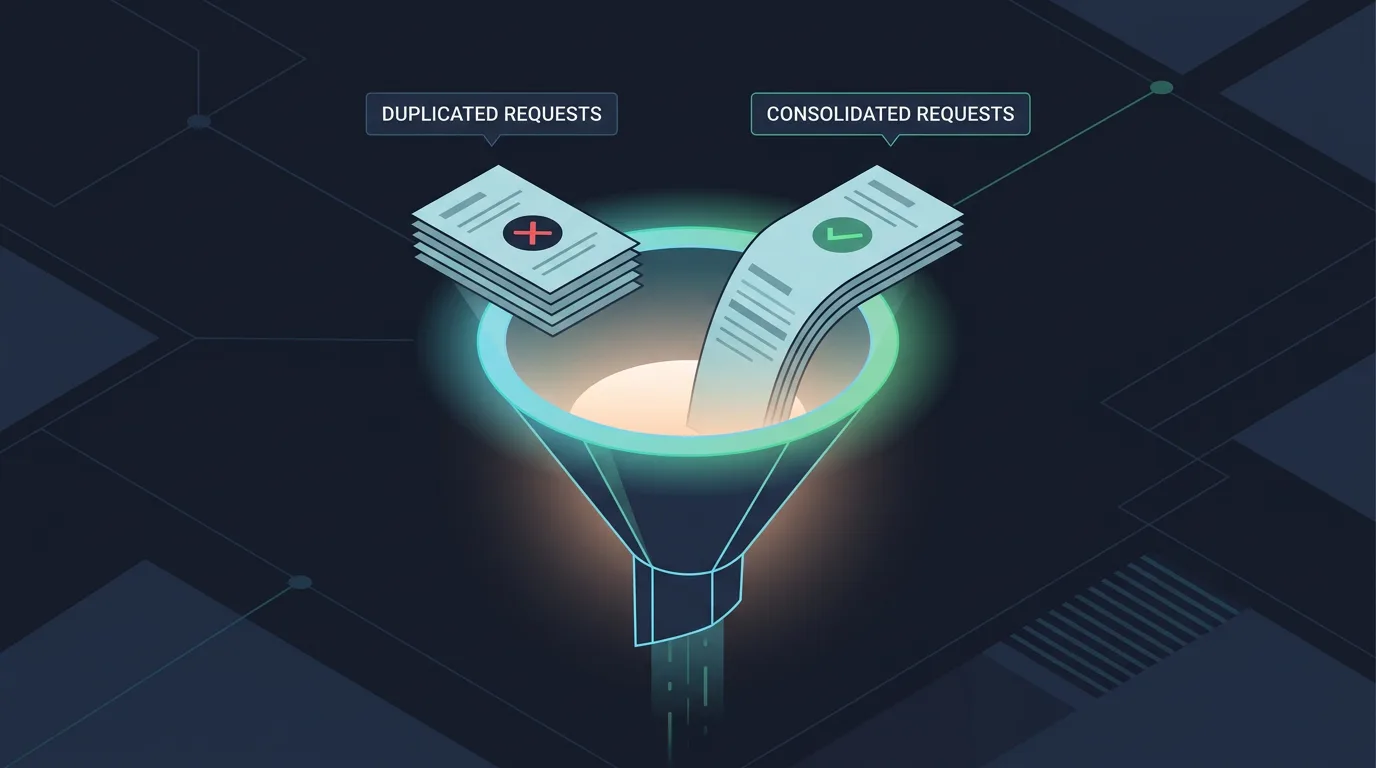
缓存解决的是「第二个请求」。合并解决的是「第一个还没跑完时到来的第二个请求」——也就是突发场景本身。
3.1 合并并发的相同调用。 当某个键已有请求在途时,新请求应挂到那个待决的 promise 上,而不是再打一次上游。
- 通过:五十个同时到达的总结请求产生一次上游调用与五十个订阅者。
- 不通过:五十次上游调用、五十笔账单,p95 延迟由五十个里最慢的那个决定。
3.2 加入前必须做鉴权检查。
- 通过:合并只发生在同一租户、同一权限范围内,或在核实加入方确实有权访问该载荷之后。
- 不通过:因为键匹配就跨用户合并——一次隐蔽的权限提升。
3.3 给扇入设上限。
- 通过:存在最大等待者数量与等待超时,迟到者回退到缓存或发起新调用。
- 不通过:一个卡住的上游请求把所有挂上去的调用方一起拖死,毫无背压。
3.4 排除智能体循环与有副作用的调用。
- 通过:多步工具调用链以及任何写状态的路由,显式退出合并机制。
- 不通过:两个订阅者共享一次执行的副作用,或者一次重试悄悄复用了半途而废的计划。
3.5 保持用量记账诚实。
- 通过:token 成本只记一次给发起方,同时对加入方记录「已节省成本」,单位经济性依然可读。
- 不通过:成本从账本里蒸发,没人能证明这次优化真的生效了。
第四部分 — 可观测性与治理
4.1 每条路由埋四个数字: 缓存命中率、被合并的请求数、估算节省的开销、按命中/未命中拆分的 p95 延迟。
- 通过:看板一眼就能回答「上周我们省了多少」。
- 不通过:你在凭感觉优化。
4.2 记录哈希后的键,绝不记录原始提示词。
- 通过:调试日志只带键前缀和路由名,提示词正文被排除。
- 不通过:缓存的副作用是把 PII 送进了日志存储。
4.3 交付急停开关与失效路径。
- 通过:一个开关可在数秒内按路由关闭缓存与合并;一次版本号变更即可让某个命名空间失效,无需手工删除。
- 不通过:缓存出问题的唯一补救方式是重新发布。
评分: 共 16 项。14 项以上通过——可以上线。10 至 13 项——在开关后面灰度,并做逐路由监控。低于 10 项——你面对的是正确性风险,不是成本问题。
关键要点
- Token 开销通常漏在冗余上而非定价上;重复执行与突发洪峰是两种最主要的形态。
- 确定性请求指纹是前提——规范化序列化,并对所有采样参数、schema、租户范围与提示词版本做哈希。
- 服务商前缀缓存与应用层去重解决的是不同问题,通常两者都需要。
- 在途请求合并带来的收益最戏剧化,因为突发天然就是并发的。
- 缓存的安全规则(不存错误、不存截断输出、租户隔离、急停开关)比命中率更重要。
下一步
- 改动任何代码之前,先在流量最高的三条 LLM 路由上埋点,观察一周的重复率。
- 按顺序实施:先做规范化哈希,再做缓存,最后做合并;每一步都放在开关后面。
- 功能上线前先写失败模式测试:提示词陈旧、跨租户合并、上游 429、流卡死。
- 两周后重跑成本报告,用看板里的「估算节省」对照,而不是只看发票。