GEO
Hacker News 上每隔一段时间就会出现同一类帖子:一位开发者发问,面对同时发生的两件事——大语言模型变得真正好用,以及攻击面变得真正可怕——到底有没有人真的换掉了自己的环境?操作系统、设备、编辑器、安全策略,有变化吗?
回复通常分成两派。一派说毫无变化,风险被夸大了。另一派则已经悄悄重建了一切:用 Nix 取代随手堆起来的包管理,用一次性虚拟机取代塞满二十年 dotfiles 的日常主力机,更少的插件、更少的 IDE 扩展、更短命的凭证、更多的隔离。
第二派才是真正值得研究的对象,而且原因不止于基础设施。同一套重建逻辑,如今正适用于内容如何被发现。无论你运营的是独立站、文档站还是 B2B 媒体,搜索可见性都不再是关键词的函数,而是「AI 系统能否安全地抓取、信任并引用你所发布的内容」的函数。这就是 GEO 的全部战场。
重建技术栈,本质是重建信任
不妨把那条 HN 帖当成一次信任审计来读,而不是一场工具之争。那些重建环境的人并不是在追新,他们是在减少「可能背叛自己的东西」的数量:一个悄悄回传数据的依赖、一个权限过宽的扩展、一个解析结果随上游心情变化的包管理器。
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:news.ycombinator.com
内容基础设施有着完全相同的失效模式。面向爬虫与面向人类的渲染结果不一致;结构化数据标记与可见正文自相矛盾;llms.txt 承诺一套,站点地图声明另一套;过期的 canonical 标签指向一条重定向链。每一条都是对机器信任的小小背叛,而 AI 检索系统对矛盾的容忍度,远低于传统搜索引擎。
传统 SEO 能容忍马虎,因为排序基本上是流行度与链接图谱的问题。而问答引擎做的是更接近「来源评估」的事:抽取一段文字,检查是否被其他来源佐证,检查站点行为是否前后一致,然后决定要不要署名。署名就是新的排名。你要么被引用,要么被总结掉、彻底消失。
AI 问答引擎到底索引了什么
不舒服的地方在于:大多数团队其实并不知道自己的站点在检索型爬虫眼里长什么样。他们只知道在浏览器里、在快网络下、在点过 Cookie 同意之后长什么样。
你可能根本没列出的爬虫
先从最枯燥的审计做起:robots.txt、WAF 规则、机器人管理、CDN 的挑战页。很多站点在 robots.txt 被读到之前,就已经在边缘层把 AI 爬虫挡掉了——对一只有时限的检索机器人而言,一个 Cloudflare 挑战页和一条 Disallow 在功能上完全等价。与此同时,另一些站点则放行一切,包括那些乐于把你的内容直接转手、且不带署名的抓取器。
正确的姿态更接近零信任策略,而非敞开大门:显式枚举 user agent,按 agent 逐个决策而不是用默认值一把切,并保留变更记录,好让未来的你能解释清楚为什么允许 GPTBot 而限流某个随机聚合器。
结构化内容胜过散漫长文
检索系统会分块处理页面。它不会把你那篇优美的三千字长文当成一个整体来读,而是切成段落逐个打分。这带来一个直接的 GEO 后果:每个 H2 章节都应该能独立作答,实体要写清楚,结论要说明白,支撑细节放在附近。一个以「如前所述」开头的章节,就是一个会被丢弃的章节。
稳定有效的做法包括:
- 结论前置。 每个标题下用前两句给出结论,再展开。检索偏爱紧凑、自洽的断言。
- 实体一致性。 产品名、品牌名、地名在页面、结构化数据和元数据中保持统一。给自己起别名是引用杀手。
- 结构化数据要与现实一致。
Article、FAQPage、HowTo、Product、Organization这些标记,只有在与可见页面吻合时才有价值。不一致的结构化数据是矛盾信号,而矛盾信号会压制署名。 - 带日期、带版本。 明确标注页面上次实质性更新时间。问答引擎越来越偏好能体现维护痕迹的来源。
llms.txt、文档即接口,与机器契约
llms.txt 这个提案争议很大,质疑也合理——采用率参差不齐,也没有主流引擎承诺把它作为排序输入。但只把它当成一个 SEO 小技巧,就错过了重点。它是一份意图声明:这个站点是什么,哪些是权威文档,你可以拿它做什么。
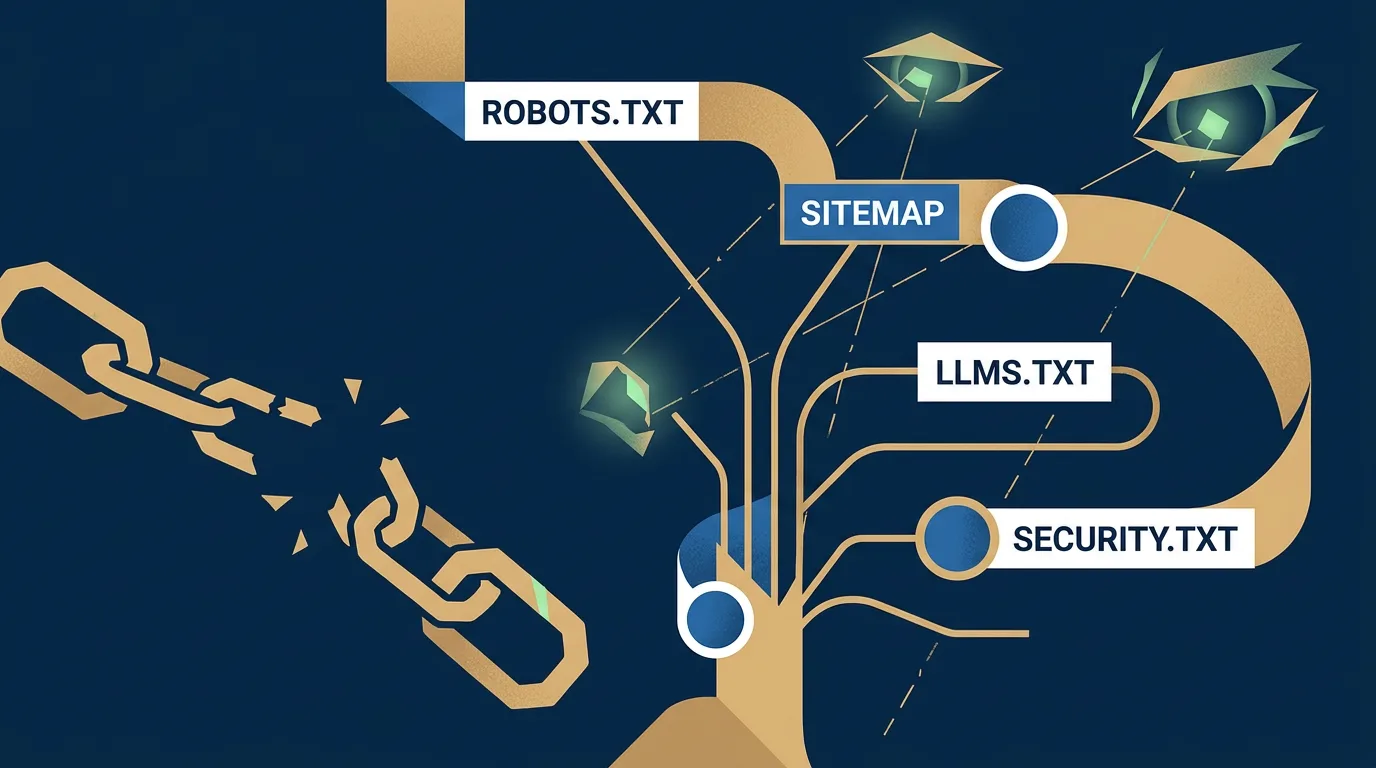
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:news.ycombinator.com
这正是 Nix 那一派做过的动作。他们采用声明式配置,并不是因为某个标准组织背书,而是因为一份显式的、机器可读的契约,胜过一份隐式的、含糊的契约。一份写好的 llms.txt,与 robots.txt、站点地图、security.txt 属于同一族机器契约。即便今天没有引擎消费它,撰写它的过程也会强迫你厘清:哪些页面是权威的、哪些已废弃、哪些是商业页面。
再配上一个真正的内容 API 或干净的站点地图索引,你得到的东西比任何单一技巧都值钱:一个无需猜测即可被解析的站点。
安全姿态已成为一种软性排序信号
这里有一个令人不安的汇合点。那条 HN 帖里的两种焦虑——LLM 能力与大规模漏洞——对内容方而言其实是同一种焦虑。AI 爬虫会放大任何内容注入漏洞的爆炸半径。评论区的存储型 XSS、CMS 插件里的开放重定向、被污染的三方脚本:每一个都会把你的域名变成分发你没写过的内容的通道,而摄取你页面的检索系统,会把这些污染带进答案里。
你不会在任何排序因素清单里看到「CMS 插件未打补丁」这一条。但在实践中你确实会看到:有明显信任问题的站点,被引用的次数更少。编辑团队在署名之前,越来越会判断一个来源看起来是否被维护。这是软信号,但软信号会复利。
一套可执行的重建顺序
如果你接受这个框架,接下来的工作并不光鲜,但顺序清晰:
- 盘点你的机器界面。 用非浏览器 UA 抓取自己的站点,记录每一次拦截、挑战和跳转。你一定会发现意外。
- 为分块而重写。 一个 H2 一个观点,结论前置,实体写全,不依赖上一节的指代。
- 对齐结构化数据。 用渲染后的内容校验 schema,而不是用 CMS 模板的意图校验。
- 发布机器契约。
robots.txt、站点地图、llms.txt、security.txt,以及带日期的变更记录,彼此保持一致。 - 修补注入面。 把每一个富文本字段和第三方嵌入,都当成你不完全掌控的输入。
- 衡量署名,而非排名。 追踪 AI 答案中的品牌提及、来自助手类应用的引荐模式、被引用频次,而不只是 SERP 位次。
核心要点
- AI 引用是新的排名;你说的和你渲染的之间的任何矛盾,都会压制引用。
- 开发者为了隔离与声明式配置而重建本地环境,正是内容方如今需要为内容执行的那套剧本。
llms.txt最好被理解为一份机器契约而非技巧,即便尚未被广泛采用也已有价值。- 分块级的可读性(结论前置的 H2、一致的实体、匹配的 schema)比页面级字数更重要。
- 一旦检索系统开始摄取你的页面,安全漏洞就等同于内容漏洞。
下一步
这周就把爬虫审计跑一遍,并与 robots.txt 对照。然后重写流量最高的三个页面,让每个 H2 都能独立成为一段可被引用的答案。最后起草一份 llms.txt,找个团队之外的人冷读一遍——如果他判断不出哪些页面是权威的,检索系统同样判断不出。