FAQ
会排查 Kubernetes 故障的 AI Agent,做演示很容易,建立信任很难。本文以 FAQ 形式汇总了一系列本地模型实验的实践教训——把语言模型接入真实集群工具,让它解释故障——并说明这些结果对希望构建「经得起复盘检验」的 AIOps 的团队意味着什么。
基础认知:工具调用究竟给了你什么
一句话版本:工具调用给了模型「触达能力」,但没有给它「判断标准」。本文其余内容都由此展开。
图示:来源页预览图(仅作编辑上下文;版权归属原发布方) · 来源引用:dev.to
在 AIOps 语境下,什么是 LLM 工具调用?
它是一种结构化的握手。模型返回一个请求,指明要调用的函数及其参数——列出某个命名空间的 Pod、拉取最近事件、读取 Deployment 的滚动发布历史——由模型之外的运行时执行并返回结果。模型本身既拿不到集群凭据,也不亲自执行任何操作。它提请求,平台来执行。这种分离是安全 Agent 最重要的架构属性,因为每一次动作都可审计、可限流。
为什么工具调用不足以支撑生产级排障?
因为「能拿到证据」不等于「对证据有纪律」。模型可以成功执行 kubectl describe pod,拿到一大段输出,然后写出一段把「输出实际说了什么」和「模型以为会看到什么」混在一起的叙述。在演示里,这读起来像专业能力;在故障现场,这正是你最承受不起的失效模式:一个自信的根因,却没人能追溯回任何具体观测。工具调用解决了管道问题,却没有触及认识论问题。
什么是确定性 AIOps?
确定性 AIOps 指的是推理路径被约束,而非自由发挥。你不再让模型自由调查并叙述结果,而是把调查过程本身编码下来:固定的取证步骤序列、每一步明确的通过与不通过判定,以及一条硬规则——结论只能引用已经采集并校验过的证据。模型的职责从「搞清楚发生了什么」收窄为「解读这份特定证据集,并提出下一步检查」。同一个模型,爆炸半径小得多。
为什么偏偏选 Kubernetes?
Kubernetes 是极好的压力测试对象,因为它的故障模式数量多、层次深,且表面症状高度相似。CrashLoopBackOff 可能来自镜像错误、缺失的 Secret、就绪探针失败、资源限制,或节点层面问题——而表层现象几乎一模一样。正是在这种模糊地带,模型「向熟悉故事做模式匹配」的倾向最危险,也是检查清单胜过直觉的地方。
实践中如何区分观测与假设?
把两者强制放进不同字段。要求 Agent 输出结构化对象,每一条论断都必须附带证据指针——某条命令的输出、某行日志、某个事件时间戳——并把任何没有指针的论断视为假设而非发现。然后做校验:重跑被引用的查询,确认引用的文本确实存在。这是很朴素的工程手段,却是「助手」与「负债」之间的分界线。
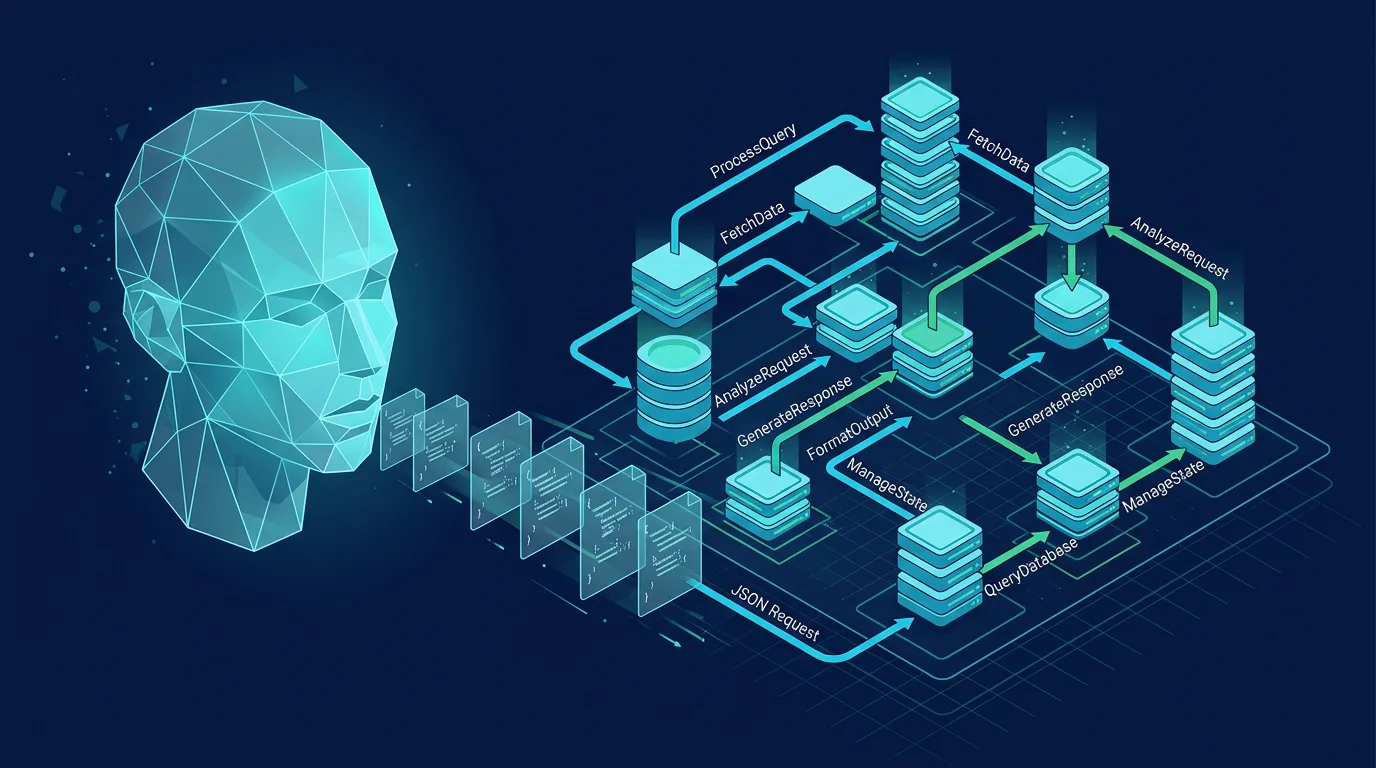
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:dev.to
证据校验层要付出什么代价?
延迟和复杂度,两者都不大。收益是:幻觉引用会在校验阶段大声失败,而不是在凌晨三点无声地生效。在实验中,大多数错误结论正是死在验证这一步——不是因为模型差,而是因为没有锚点的论断扛不住一句「拿给我看」。
模型应该直接执行修复动作吗?
把修复当作一项独立、显式受控的能力。默认可读诊断,写操作需人工批准。如果团队确实要放行 Agent 动手,动作集应当枚举化、限定到命名空间或标签选择器范围、尽量可回滚,并连同支撑它的证据一起记录。你要防范的不是恶意,而是一个听起来合理、实则错误的假设被迅速执行。
更小的本地模型能胜任吗?
往往可以,因为难点被搬走了。当调查变成一条既定序列、输出格式被约束之后,模型做的是摘要和下一步选择,而不是开放式侦探工作。小模型完全能胜任,并且让敏感的集群上下文留在我方可控的基础设施内——对受监管团队而言这是实打实的优势。代价是格式服从性更脆弱,而这恰好由校验层兜住。
如何评估一个 AIOps Agent?
不是看它的解释听起来对不对。用一批已知根因的历史故障回放证据,分别打两个分:Agent 是否得出正确结论,以及它引用的证据是否真的支撑该结论。第二个数字才是预测生产表现的那个,而它几乎总比团队第一次跑出来的预期要低。
这会取代 Runbook 或值班工程师吗?
不会,它压缩的是故障处理中那段枯燥的「中间地带」。Agent 擅长并行取证、汇总嘈杂日志、提出下一步检查。优先级判断、客户沟通和不可逆决策仍然由人负责。把它理解为「一个记性完美、判断力为零的快速初级响应者」,比理解为「自主运维」更接近现实。
最关键的一个指标是什么?
获得「可辩护假设」所需的时间。不是任何一个假设,而是你能用评审者看得懂的证据加以论证的那个假设。这个指标同时奖励速度与纪律,而且不会因为模型语气自信就给它加分。
团队该从哪里起步?
挑一类狭窄但高频的故障——镜像拉取失败、就绪探针失败、资源限制导致的 OOM Kill。手写出它的确定性调查路径,写成一名新工程师能照做的检查清单。然后让模型执行这条路径并做总结。只有在回放测试中证据校验站得住之后,再扩展范围。
关键要点
- 工具调用授予的是证据访问权,不是判断证据的标准。
- 确定性 AIOps 约束推理路径,使结论可追溯,而不只是「听起来合理」。
- 每条论断都应携带证据指针,每个指针都应在人读到之前重新校验。
- 诊断默认只读;写操作必须处于显式、限域、可审计的审批之后。
- 评估 Agent 要看回放故障中的引用准确率,而不是叙述的说服力。
下一步行动
本周内把一类故障写成手写诊断清单;让 Agent 输出带证据指针的结构化论断;用五个已知根因的历史故障构建回放集,先测引用准确率,再谈其他任何指标。
来源
- From LLM Tool Calling to Deterministic AIOps: Lessons from Kubernetes Troubleshooting — Dev.to