Nebius
不重写代码,把 LLM API 成本砍掉 70%:一份 FAQ
一位开发者在 Dev.to 上记录了这样一件事:副项目的 LLM 月账单停在 208 美元左右,他用三个月把同样的功能压到约 60 美元——没有重训模型,没有重构代码,输出质量也看不出下降。改变的绝大部分是请求的构造方式,而不是应用架构。下面是可落地的版本,按团队看到账单时真正会问的问题来组织。
为什么 LLM 账单涨得比用户数还快?
图示:来源页预览图(仅作编辑上下文;版权归属原发布方) · 来源引用:dev.to
**简短回答:**因为你按 token 付费,而不是按用户付费,而单次请求的 token 数会悄悄膨胀。
成本是四个量的乘积:输入 token、输出 token、调用次数,以及你所选模型的单价。只有第三项随用户增长。另外三项会自己往上爬——每一轮都完整重发的对话历史、从博客里复制粘贴拼出来的系统提示词、没有上限的补全长度,以及超时后立刻再发一次全价请求的重试循环。
一个在会话里发了三条消息的用户,成本不是三次请求那么简单。那是三次请求,每一次都背着比上一次更长的对话记录。看似线性的产品使用量里,藏着接近平方级的增长。
常见问题
1. 钱到底花在哪?
输入 token、输出 token、调用量、重试、模型档位——按常见浪费程度排序。输出 token 的单价通常是输入的数倍,所以「不设上限的补全长度」往往是代码库里最贵的默认值。
2. 真的能不碰代码就省钱吗?
大体可以,但「不碰代码」的准确含义是「不改架构」。实际操作中,杠杆在三处:环境配置(模型 ID、token 上限、超时)、提示词模板(那是文本,不是逻辑),以及供应商侧的控制项,比如缓存和预算告警。这是编辑,不是重工程。
3. 一次请求里有多少上下文是浪费的?
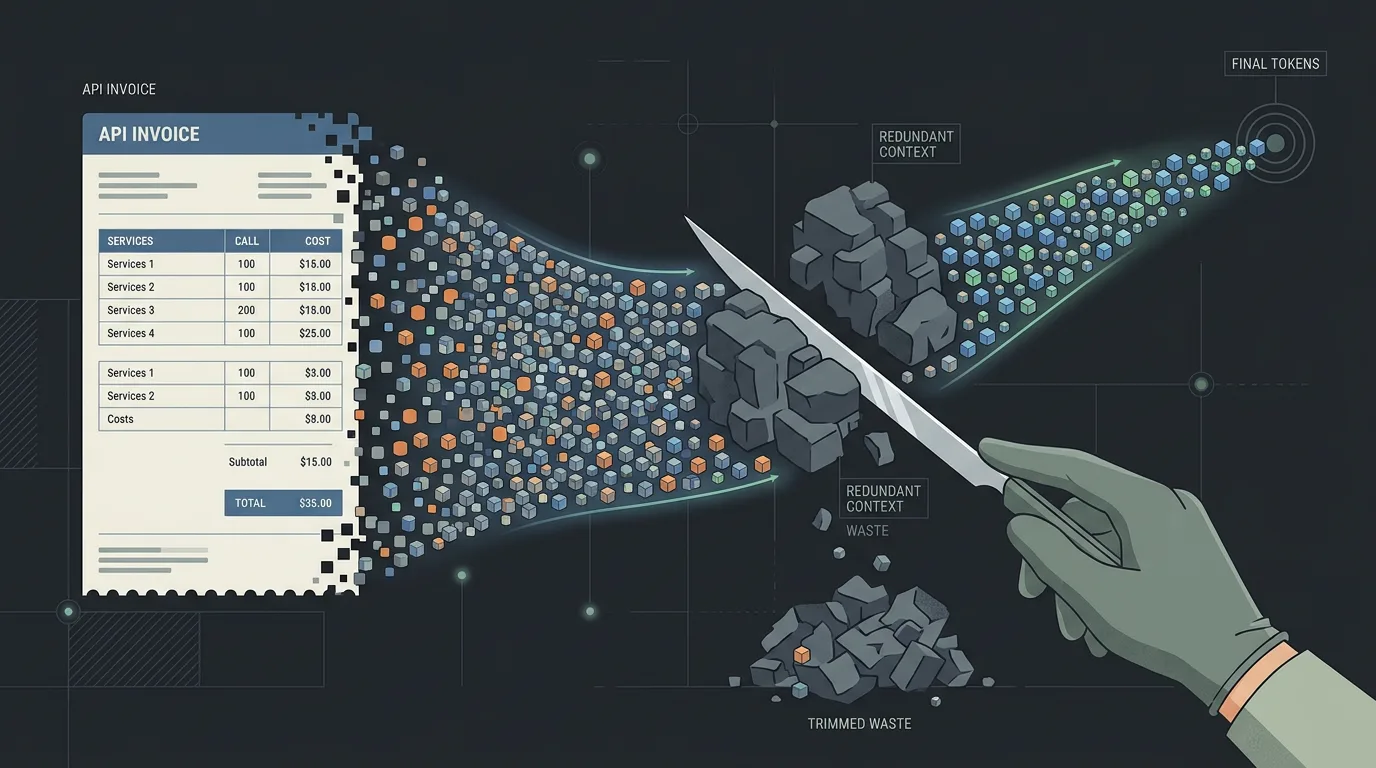
往往是大部分。过期的历史轮次、过时的检索文档、重复的指令、每次都重发的样板文字,全都按输入 token 计费。有个好习惯:把一条真实请求的完整负载打印出来,当作按字付费那样读一遍。多数团队会发现至少三分之一可以直接删掉而不影响质量。
4. 什么是提示词缓存,为什么重要?
如果请求开头是一段很长且稳定的内容——系统提示词、工具定义、参考文档——一些供应商允许你缓存这个前缀,重复请求按折扣价计费。设计规则很简单:把永远不变的东西放最前面,把每次请求才变的变量放最后。任何位置变动都会让缓存命中失效。
5. 更便宜的模型一定输出更差吗?
不一定,但混用模型需要工程支撑。生产环境中很大比例的调用是分类、抽取、摘要、格式化,这些任务在小而快的模型上往往够用。把贵的那一档留给真正的多步推理,其余全部路由到下游。要写的代码是一个路由函数加一套评测集,不是重写。
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:dev.to
6. 怎么压缩输出 token?
和压缩任何无上限资源一样:加上限。设置一个符合「最长合理答案」的 max_tokens;当下游系统要消费时,要求结构化输出而不是散文;加停止序列;删掉那些鼓励长篇大论的指令(「详细解释」「务必全面」)。对产品界面来说,更短的输出通常也更好。
7. 重试是怎么悄悄推高花费的?
一次超时后自动重试,意味着一次用户操作你付了两次钱,而且第一次调用在服务端可能已经完成。加上指数退避、限制重试次数,并确保幂等路径不会因为本可自愈的瞬时错误而重复触发。挂住的流式连接是常见元凶。
8. 每周该盯哪些指标?
先五个就够:单次请求成本、活跃用户人均成本、输入输出 token 比、缓存命中率、p95 延迟。如果单次请求成本在降、人均成本却持平,那是用量增长问题而不是效率问题——解法不同。
9. 应该先优化什么?
按投入产出排序:限制输出长度、删除冗余的系统提示词、对历史做窗口化或摘要、缓存稳定前缀、把简单任务路由到小模型,最后再把非面向用户的调用批处理。多数团队前四项就能拿到大部分收益。
10. 精简上下文会伤质量吗?
有时会,所以要测量而不是猜。保留一小组真实提示词和已知正确答案,每次改动前后跑一遍对比。没有这套基准,任何优化都是抛硬币,而团队往往在第一个负面工单之后就全部回滚。
11. 流式与批处理会改变成本吗?
流式改善的是感知延迟,并不减少 token——如果用户中途放弃,甚至可能更多。对非交互工作,批处理才是真正的杠杆:夜间摘要、历史回填、重新打分,往往可以挪到更便宜的批处理档位或低谷时段。
12. 怎么防止省下来的钱又涨回去?
让成本在改动发生的地方可见。一个按功能拆分的花费看板、一个你真的会行动的预算告警,以及代码评审里的一张短清单(设了 token 上限吗?上下文精简了吗?模型档位有理由吗?),比任何一次性清理都管用。没人盯着的那一刻,成本就开始回归。
关键要点
- LLM 支出随「每次请求的 token 数」增长,而不只随用户增长——历史重发和啰嗦的提示词会悄悄放大账单。
- 最大的收益通常来自配置和提示词文本:输出上限、精简系统提示词、历史窗口、缓存前缀。
- 按任务难度路由。生产环境大多数调用很简单,不需要最贵的模型。
- 重试和超时是一张隐藏的第二账单,要当作成本面来治理,而不只是可靠性功能。
- 一定要对着小规模评测集做优化,否则你省下的钱会以质量为代价,且无法自证。
下一步
- 拉出上个月按功能和按模型拆分的用量明细。
- 每个功能记录一条完整请求负载,标出可删除的部分。
- 在所有缺失的地方补上
max_tokens和超时。 - 在调整模型档位之前,先建一套 20–50 条提示词的评测集。
- 把「活跃用户人均成本」加进周报看板,并设置预算告警。