agentic commerce
Oracle 与 OpenAI 的合作究竟意味着什么
标题读起来像一条产品通告:Oracle 的业务应用与 AI 智能体被引入 ChatGPT,而 Oracle 的产品反过来由 OpenAI 的模型驱动。但更值得关注的是一种模式,而不是某一款产品。
前沿实验室已经不再卖「一个聊天框」,而是开始卖分发渠道——直接进入工作真正发生的地方:ERP、HCM、供应链、CRM。Oracle 提供的是系统记录与企业级销售通路,OpenAI 提供的是模型层,以及员工不需要培训课件就能上手的界面。
对于正在评估技术栈的团队,真正的问题不是「我们要不要迁到 ChatGPT」,而是「智能体应该住在哪一层,底下的数据契约由谁负责」。这个框架决定了你做出来的是一个有用的试点,还是一个做了半年、最后只剩一页 PPT 的集成项目。
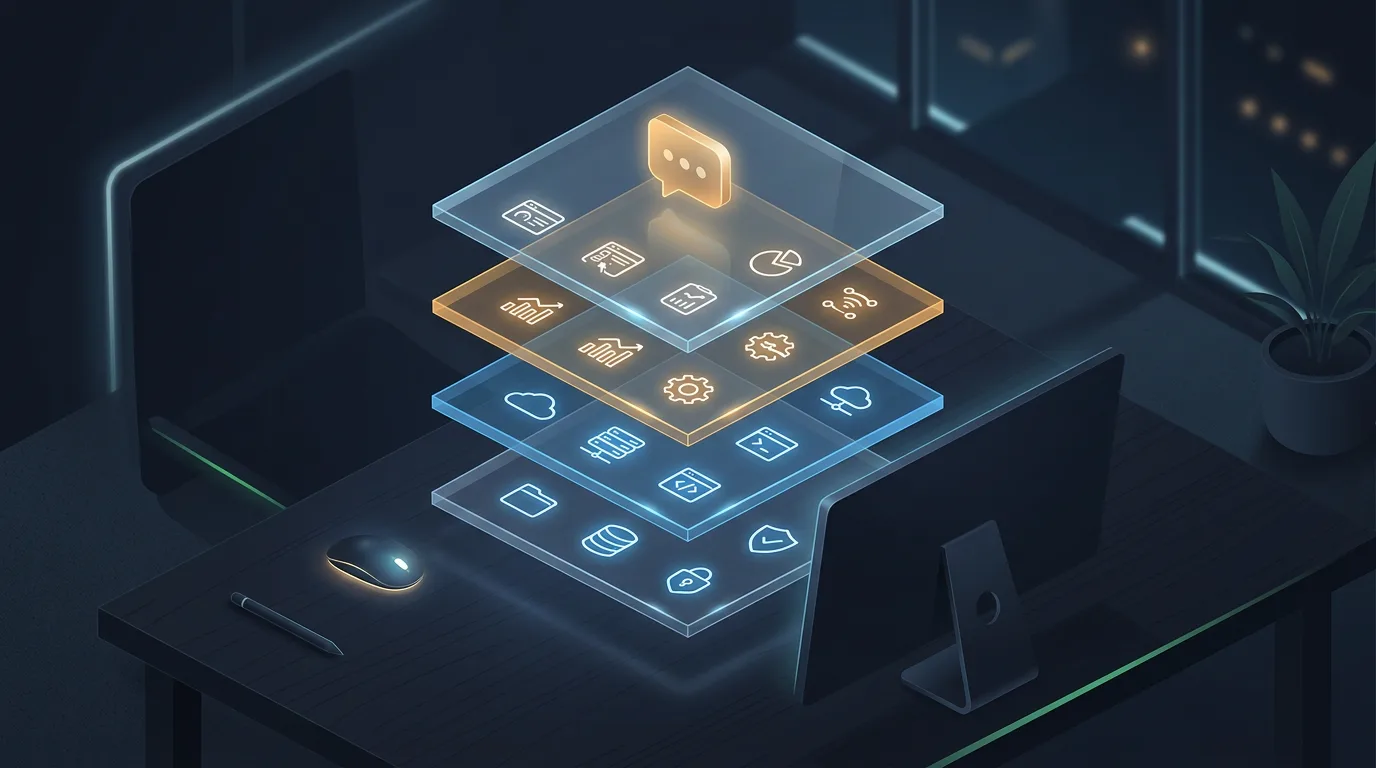
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:openai.com
盘点:值得对比的四个层次
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:openai.com
几乎每一个企业 AI 决策,最终都会落在四个层次之一。厂商会跨层竞争,但采购时应当分层评估,因为每一层的失败方式各不相同。
一、助手层:ChatGPT 应用、Copilot、Gemini、Claude
这是员工实际打字的界面。它的优势是采用率:没有人需要被教会怎么提问。接入应用之后,助手就变成一个总机,可以伸进业务系统里取数,而用户不必再学第二套界面。
适用场景:瓶颈在人的吞吐量——起草、摘要、工单分诊、拿表格去对照制度文件。不适用场景:流程要求确定性的、可审计的状态流转。聊天记录不是审批记录;一个「通常」能记对凭证的助手是负债,不是工具。
二、套件层:Oracle Fusion、SAP、Salesforce、Workday
每一家大型套件厂商现在都在推自己的智能体界面和自己的模型合作。Oracle 与 OpenAI 的安排只是这一普遍趋势的一个实例:应用厂商把自己定位成你的数据与模型供应商之间可信的中间人。
适用场景:你的数据重心本来就在这个套件里,且合规团队希望只有一个具名的交易对手。不适用场景:你运行的是多套件环境,而每家都希望成为唯一的驾驶舱。最后你会得到四个智能体控制台、零共享记忆,这比一张诚实的电子表格还糟。
三、胶水层:MCP 服务器、iPaaS、工作流工具
这是最不性感的一层,却决定了项目能不能上线。MCP 服务器、集成平台和工作流引擎,解决的是智能体如何发现工具、如何认证、如何拿到一把有范围的钥匙而不是总钥匙。
适用场景:一个智能体需要触碰三个系统,或者每一次工具调用都必须留痕以备审计。不适用场景:原生连接器已经能完成任务——胶水层是延迟和成本悄悄堆积的地方,为了取一条记录而串五个跳转,本身就是设计异味。
四、自建层:OCI Generative AI、Azure AI Foundry、Bedrock、Vertex
如果你要建的东西确实属于你自己——定价引擎、理赔分诊模型、基于专有文档的内部副驾——它就应该待在这一层。Oracle 的合作在这里同样有意义:模型落到你已经在跑的云上,主要是采购和数据驻留上的收益,而不是能力上的跃升。
适用场景:差异化在你的数据或你的评测集里。不适用场景:你在重建一个每月二十美元席位就能覆盖的通用摘要器。
一页式的选择指南
| 情境 | 起步层次 |
|---|---|
| 知识工作者淹没在文档里 | 助手层,配两到三个有范围的连接器 |
| 受监管流程,需要审计轨迹 | 先胶水层,再助手层 |
| 单一套件环境,供应商关系稳固 | 套件层,但要硬谈条件 |
| 专有评测数据就是护城河 | 自建层 |
| 多套件、无人负责 | 停。先指定负责人,再谈采购。 |
什么时候这些都不该买
如果你说不出应该被推动的那个指标,就先别买。「生产力」不是指标,「工单平均关闭时长」才是。如果团队里没有人看得懂工具调用日志,也先别买,因为你将盲目调试。如果你的主数据一团糟,同样别买——智能体会把不一致的记录放大成自信满满的错误答案,而且比人快得多。
还有一个更简单的规则:如果试点还没扛过一整个月的真实用户,就别升级到企业版。升级通道永远开着,而一次失败上线烧掉的信任不会重来。
会在后面咬你一口的定价陷阱
厂商很少在价格上说谎,他们只是用另一套计量单位来描述,而最终你会按另一种单位付钱。
- 席位 vs. 消耗。 多数助手层按席位计价,然后对高级模型调用或接入应用的动作另行计量。第二个计量表才是预算崩掉的地方。
- 按智能体 vs. 按动作。 套件智能体常按智能体数量或工作流数量授权,看起来便宜,直到你给每个部门都部署一个。
- 模型路由。 如果由厂商按请求挑选模型,你就继承了他们的成本曲线和他们的升级节奏。要问清楚:合同期内价格变动由谁吸收。
- 数据出网与驻留。 把负载整合到云伙伴上省下的钱,可能在回程出网费上被抹平。先读退出条款,再读进入条款。
- 试点价不是续约价。 首年折扣是获客成本,不是运行成本。按第三年建模。
核心要点
- Oracle 与 OpenAI 的联手是一个分发故事,不是能力故事:模型去数据和用户已经在的地方。
- 先定层次,再选厂商。助手、套件、胶水、自建,各有各的失败模式。
- 胶水层枯燥但具决定性。如果没人负责认证与日志,「上线」二字无从谈起。
- 聊天界面不是审计记录。确定性的流程就让它保持确定性。
- 按第三年建模成本,把出网费、高级模型调用和按智能体授权都算进去。
下一步行动
- 盘点那些智能体会触碰系统记录的工作流,并为每一个指定负责人。
- 在助手层跑一个四周试点,连接器不超过三个,且每个都限定范围。
- 从第一天就记录工具调用日志——这是区分「模型问题」和「数据问题」的唯一办法。
- 任何续约之前,索取接入应用动作与高级模型调用的消耗明细。
- 只有试点产出了一份值得拥有的评测集之后,再回头评估自建层。