AI agents
大多数团队以为智能体出问题是因为模型不够聪明。但在生产环境里,第一次事故往往来自一件更枯燥的事:工具列表太长了。四十个接口,每个都带 schema、枚举,以及十八个月前某人赶工写下、从此再没人看过的描述。智能体不是败在推理上,而是败在选择上。
Google 在 Gemini API 中预览的工具检索(Tool Retrieval)正是针对这个失效点:让智能体在消耗更少 token 的情况下访问数百个工具。但如果只把它理解成省 token 的功能,就低估了它的意义。它实际上承认了一件事——智能体的工具层本质上是一个检索系统,而多数团队一直把它当成一段提示词在处理。
工具膨胀是智能体项目里最安静的成本
图示:来源页预览图(仅作编辑上下文;版权归属原发布方) · 来源引用:blog.google
你挂在请求上的每一个工具定义,都是模型必须承载和权衡的上下文。列表一长,会同时造成三种伤害。
注意力被稀释。 当桌面上摆着四十个候选,模型必须在一堆近义工具之间做区分——search_customers、find_customer_by_email、lookup_account。选择准确率并不是随列表长度平滑变化的,它会在“好几个工具看起来都说得通”的模糊地带明显下滑。
每一轮都要付费。 schema 不是免费的。目录一大,每一次调用都会膨胀,包括那些只需要一个工具的无聊请求。这笔成本会在重试、子智能体和多步循环中悄悄叠加,直到有人发现账单不对劲。
描述会腐烂。 描述与真实行为逐渐脱节。某个字段改名了,某个默认值变了,描述就变成了一句模型会自信执行的谎话。因为没有人真正拥有这个目录,所以也没有人去修。
工具检索到底改变了什么
机制对做过 RAG 的人来说很熟悉:不再一次性加载所有工具 schema,而是在规划之前先用检索步骤筛出相关子集。token 更少、余量更多,理论上因为候选集更小更聚焦,选择质量也会更好。
更重要的是它逼出来的设计纪律。当工具选择变成检索,你的工具描述就不再是提示词装饰,而是一份可被索引的语料。措辞、同义词、示例、粒度——所有这些都得“能被找到”,而不只是“能被读懂”。这是一门不同的手艺,更接近搜索相关性工程,而不是写提示词。
失效模式也跟着变了。今天的常见抱怨是“模型选错了工具”。而引入检索后,更隐蔽的失败是“正确的工具根本没被召回”,然后智能体为了显得有用,用手上仅有的东西即兴发挥。静默的召回失败比可见的误选更难排查,因为整条链路看起来完全合理。
反向观点:检索可能掩盖架构问题
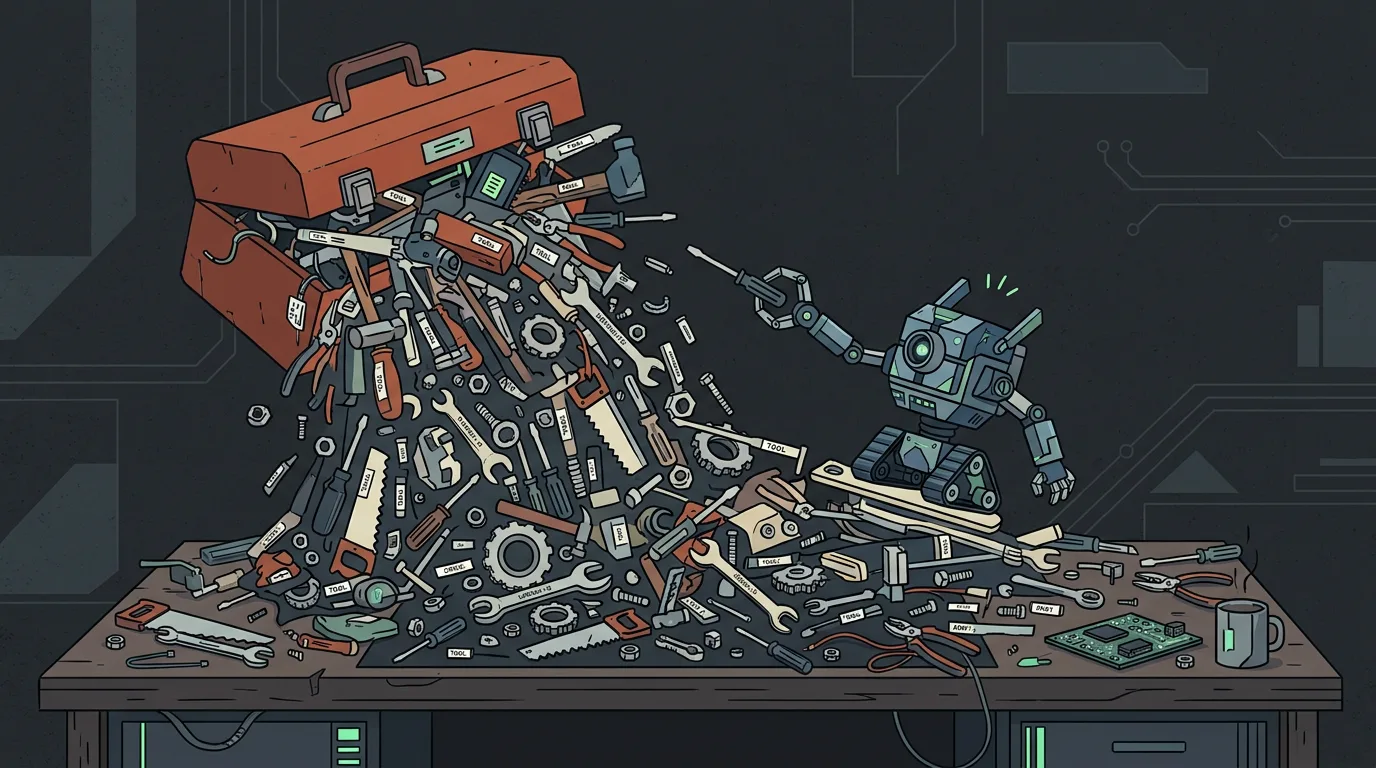
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:blog.google
说难听一点:如果你真的需要一个智能体够得着三百个工具,那问题可能不在工具数量,而在架构。一个动作面极其庞大的单体智能体,人难以推理,模型也难以路由。拆成若干个更窄的智能体、每个只带一组精选工具,往往比把巨型目录做成可搜索的更有效。
检索方案本身也有真实代价。它引入了第二个需要评估的东西:你必须把“工具子集召回率”和“任务成功率”分开度量,否则会错误归因。它增加了一跳延迟,还引入了一个排序行为基本不可观测的依赖。而且它对更难的问题毫无帮助——语义重叠。两个几乎同义的工具,无论你是检索出来的还是全量加载的,模型照样会困惑。
所以理性的姿态比宣传口径要窄得多。把检索用在长尾上:租户专属集成、极少使用的管理操作、你必须支持但几乎没人调用的上百个连接器。核心的五到十个工具应当常驻、精心撰写、坚决去重。检索是应对“广度”的好答案,但它替代不了“清晰”。
功能背后的趋势
退一步看,规律很明显。智能体正在获得所有成熟系统都会长出的中间件:路由、缓存、访问控制,现在是对能力集的检索。工具层正在被专业化成一个注册表——有版本、有归属、有可观测性、有索引。
这会带来组织层面的影响。拥有工具目录的团队,正变得和拥有提示词的团队同样重要。而那些允许你检查、评估、覆盖检索步骤的厂商,会在企业对话中胜出;一个偶尔“忘记某个工具存在”的黑盒,很难说服任何有值班轮班制度的团队。
30 天行动计划
第 1 周——盘点与埋点。 导出智能体能触达的全部工具定义,按智能体统计数量。然后记录生产环境中真正被调用的工具,以及从未被调用过的工具。多数团队会发现一条自己在为之付费的长尾,以及一组投入不足的核心工具。
第 2 周——先治理,再检索。 重写描述,说清这个工具做什么、何时该用、何时不该用。合并近义工具。下线死接口。仅这一周的工作,通常比任何基础设施改动带来的可靠性提升都多。
第 3 周——分区。 把目录拆成常驻核心与可检索长尾,明确划出边界并写进文档。如果核心超过十几个工具,那是该拆智能体的信号,而不是把核心继续扩大的理由。
第 4 周——先建评估,再做集成。 准备五十到一百条真实请求,标注每条应当选中哪个工具。分别度量选择准确率和子集召回率。完成之后,再把检索链路放在开关后面灰度对比基线。
关键要点
- 工具膨胀会降低选择准确率、抬高单轮 token 成本并悄悄腐烂,检索能很好地缓解症状。
- 工具检索把工具描述重新定义为可检索索引,要求的是搜索相关性纪律,而非写提示词的直觉。
- 新的主要失效是静默召回失败:正确工具没被召回,智能体于是看似合理地即兴发挥。
- 检索适合解决广度,不适合解决歧义。工具之间的语义重叠仍然需要人工治理。
- 一个巨型可搜索目录,往往说明你本该拆成几个更窄的智能体,而不是养一个什么都吃的。
下一步
- 本周就审计目录,把每个工具标记为核心、长尾或待下线。
- 在动 API 之前先搭好工具选择评估集,这样你才能区分“真的变好了”和“只是噪声”。
- 把相关工具召回率提升为一等指标,与任务成功率并列。
- 给工具注册表指定明确的负责人——没人拥有的描述最终都会变成谎话。
来源
- Google AI Blog:Introducing Tool Retrieval in the Gemini API