AI agents
DoorDash 到底改了什么
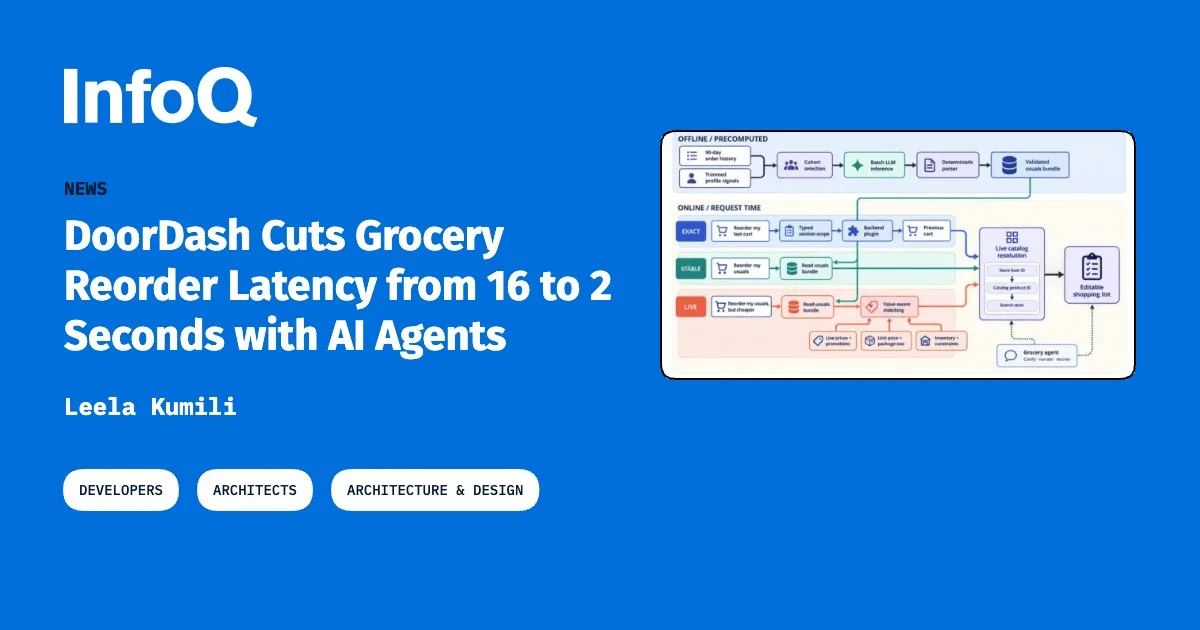
图示:来源页预览图(仅作编辑上下文;版权归属原发布方) · 来源引用:www.infoq.com
DoorDash 的生鲜杂货复购流程过去端到端大约需要 16 秒,按 InfoQ 报道的工程实践,现在约 2 秒完成。真正的变化不在于换了更快的模型或更小的模型,而在于模型什么时候跑、以及什么环节被允许留在关键路径上。
起作用的是三步。
第一,用批量 LLM 推理提前算好每位用户可能重复购买的商品,把昂贵的推理挪到点击之外,而不是塞进点击之内。第二,确定性校验层在结果触达用户前把关——走规则与结构校验,而不是再叫一个模型去给第一个模型打分。第三,实时商品目录解析在渲染时把预计算结果与当前的商品、价格、库存对齐,避免几小时前生成的预测把一个已下架或已调价的商品推到用户面前。
可编辑的购物界面补上最后一环。当预计算的购物篮出错时,用户直接改,而不是触发又一轮推理。
官方口径的结果是:购物清单浏览量翻倍,该流程下单率提升约 34%。这两个数字都由公司自行披露,未公布基线定义,所以方向值得参考,小数位不必当真。
16 秒是产品问题,不是基础设施指标
生鲜复购是电商里最具惯性的交互。购物篮按周基本稳定——同一款牛奶、同一个品牌、同一个规格。16 秒足够让用户想起自己本来要做别的事、切个标签页,然后不回来了。团队习惯把延迟归到 SRE 的账上;但在重复购买场景里,延迟就是产品界面,后面直接挂着收入。
让复购有价值的这种「稳定性」,同时也让它不适合实时推理。大部分智力工作与系统上周已经算过的东西完全一样。为了重新发现一个已知购物篮而在每次请求上跑通用模型,既贵、又慢、还不确定——这三个属性你都不希望出现在转化率最高的路径上。
对其他团队有用的问题是:你的哪些 AI 功能,其实是一个批处理任务穿着请求时推理的外衣?
模式:提前预测、廉价校验、实时解析
这套架构的价值来自把一个通常被塞进单条提示词的职责拆成三层。
预测可以是过时的、概率性的、按计划重算的。校验必须是确定性的、廉价的、在关键路径内的。解析必须是实时的,但它只是一次查表,不是一次生成。把模型关在第一个盒子里、赶出另外两个盒子,才是把八秒的模型调用变成一个两秒页面的关键。
成本账同样成立。批量推理单 token 更便宜,可以排在闲置算力上;而流量高峰时的实时推理,是账单和 p99 同时爆炸的地方。预计算把一个随点击量增长的变动成本,换成了随用户数增长的固定成本——对每周都要用一次的流程来说,这条曲线好得多。
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:www.infoq.com
风险是陈旧,而且它没有完全消失。实时目录解析能覆盖 SKU 漂移:下架、调价、缺货。但覆盖不了意图漂移:新家庭成员、饮食改变、搬家、新生儿。可编辑界面是一种诚实的承认——预测会错,用户是兜底方案。这比假装模型永远正确、把纠错藏进客服工单要健康得多。
确定性校验的价值在哪里
这条流程里的护栏都不性感:结构合法性、数量合理性、过敏原标记、价差阈值、禁配替换。但每一条都可审计。你能向商家或监管解释,系统为什么提出了这个购物篮。模型监督模型既不便宜也不可解释,而且失败是相关的——当第一个模型自信地错,第二个往往点头同意。
这里的「智能体」到底指什么
这个标签承担的重量比看上去小。这是一条流水线,模型只占其中一段,被校验和对齐逻辑约束住——不是一个在商品目录里自主谈判的循环。收益来自约束智能体,而不是放大它。这是可以迁移的那一课。
接下来要盯什么
- 预计算窗口。 预测提前多久做、多久刷新一次、什么事件触发重算?太长就浪费算力在不会下单的人身上,太短就又回到实时推理。
- 模式能否外溢。 餐饮复购、订阅、补货提醒都具备「购物篮稳定」的特征。如果生鲜成立,同样的形状应该会出现在产品的其他位置。
- 猜错的评估。 「是否正确预测了周期商品」的精确率和召回率是多少?没有披露,但对想抄这套的人来说是最重要的数字。
- 那 34%。 是相对真实对照组的提升,还是自然波动?其中多少来自延迟本身,多少来自新的可编辑界面?这是两个不同的投资决策。
- 单位经济。 批量推理不是免费的。只有总推理支出持平或下降,这个胜利才成立;否则只是把开销搬了个地方。
关键要点
- DoorDash 称生鲜复购延迟从约 16 秒降至约 2 秒,购物清单浏览量翻倍,下单率提升约 34%。
- 收益来自把 LLM 工作移出请求路径、改用批量预计算,而不是换了更快或更小的模型。
- 确定性校验(结构、数量、过敏原、价差)留在关键路径内,且具备模型互评所没有的可审计性。
- 实时商品目录解析处理 SKU 与价格漂移;可编辑界面处理意图漂移。
- 高频、低方差的交互最适合预计算,最不适合每次请求都推理。
- 快不等于好:要衡量实时推理带来的那点额外准确率,是否真的值得多花的那几秒。
下一步建议
- 盘点自己产品里的 AI 界面,找出可以改成定时任务的请求时计算。优先从用户每周至少用一次的功能入手。
- 把每个功能拆成预测、校验、解析三层,并明确写下哪一层允许是不确定的。
- 任何涉及金额、库存或过敏原的模型输出,前面都加一道确定性过滤。
- 把预测准确率与转化率分开埋点,避免延迟收益掩盖了相关性退化。
- 为每个功能定义新鲜度预算:预计算的结果最多可以陈旧多久,超过就必须重算或丢弃。