Deep dive
有一种特别的疲惫来自 AI 编程代理,但它不是写提示词的疲惫,而是「考古」的疲惫——翻回一个已经关闭的对话,去确认哪个 report_v3_final.md 才是基于你真正信任的那份来源构建的;上次那句「完成了」到底是指已保存、已复核,还是已发送;以及哪些检查项被承诺过却从未真正执行。
Retulo 直接回应了这种疲惫。它是一个 MIT 许可的 Python CLI,同时附带一个 MCP 服务器。它的主张范围很窄,但很有用:产出文件的任务应当拥有一个持久的本地工作区,把任务身份、来源素材、输出版本、已记录的决策、剩余工作和检查项放在一起——这样开启新对话时,就不必再从聊天记录里重建整个工作。官方同时提供了 Codex 与 Claude Code 的配置说明,这已经说明了作者的预期场景:它服务于代理式编程循环内部,而不是独立使用。
下面分析它的机制、随之而来的取舍,以及在什么条件下这份额外的运维开销才值得。
为什么聊天记录不是合格的文件系统
对话式代理本质上无状态,却意外地积累了状态。聊天记录于是成了事实上的记录载体,由此产生三个结构性问题。
指代模糊。 当用户说「用最新的来源」,代理是针对上下文窗口里的内容去解析这句话的。关掉标签页、第二天再打开,同一句话的解析结果可能不同——甚至根本无法解析。文件还在,出处却没了。
决策依据丢失。 代理为什么选了 A 库而不是 B 库、为什么用这个 schema 而不是那个,这些推理散落在三轮之前的散文里。下一次会话会重新推导一遍,而且往往推出不同结论——这是长周期工作中隐蔽的返工来源。
完成状态无法验证。 「完成了」是代理输出里被重载得最厉害的词。文件写了吗?复核了吗?校验步骤是真的执行了,还是只是被描述成执行了?聊天记录记录的是断言,不是证据。
图示:来源页预览图(仅作编辑上下文;版权归属原发布方) · 来源引用:dev.to
Retulo 的判断是:这些不是提示词问题,而是缺失的基础设施问题。对应的解法不像「更聪明的模型」,更像「一个带 schema 的、小而无聊的本地数据存储」。
Retulo 究竟做了什么
以任务身份为锚点
核心抽象是「任务」,既不是会话也不是文件。一个任务在磁盘上拥有一个工作区:来源素材进、输出产物出,两者始终挂在同一个身份下,跨越会话、跨越工具,也——这一点很关键——跨越模型更换。如果你中途从一个代理 CLI 换到另一个,任务依然存在,只是接口变了。
这个粒度选得对。文件太细:最后你会得到一个没人读的版本图。项目太粗:你无法说清「这一份具体交付物已经完成」。
版本、决策与检查是一等记录
这个工作区不只是一个文件夹,它还承载结构化条目:
- 输出版本:让「最新」拥有一个不依赖上下文窗口的定义。
- 已记录决策:让依据可以被取回,而不是被重新推导。
- 剩余工作:让被中断的任务拥有显式队列,而不是隐含队列。
- 检查项:让验证成为一个有名字的义务,而不是一种感觉。
「检查项」这个概念影响最大,也最不性感。记录「这还需要跑」的代理,产出的是一个可审计的未闭合回路;记录「这已通过」的代理,产出的是一个断言。其价值完全取决于工具是否强制区分这两者——而这恰恰是大多数实现会漏水的地方。
用 MCP 作为集成面
选择 MCP 是架构上最有意思的部分。Retulo 没有为每个代理产品写定制集成,而是把工作区操作暴露为 MCP 工具,任何支持 MCP 的客户端都能驱动它。这是真正的解耦:存储的生命周期长于填充它的代理。
代价是工作区的 schema 变成了公共契约。一旦 Codex、Claude Code 以及下个季度出现的任何新客户端都在读写同一批记录,改动一条决策记录的形状就是对所有人的破坏性变更。早期 schema 往往定义不足;在这里,定义不足是兼容性负债,而不只是小麻烦。
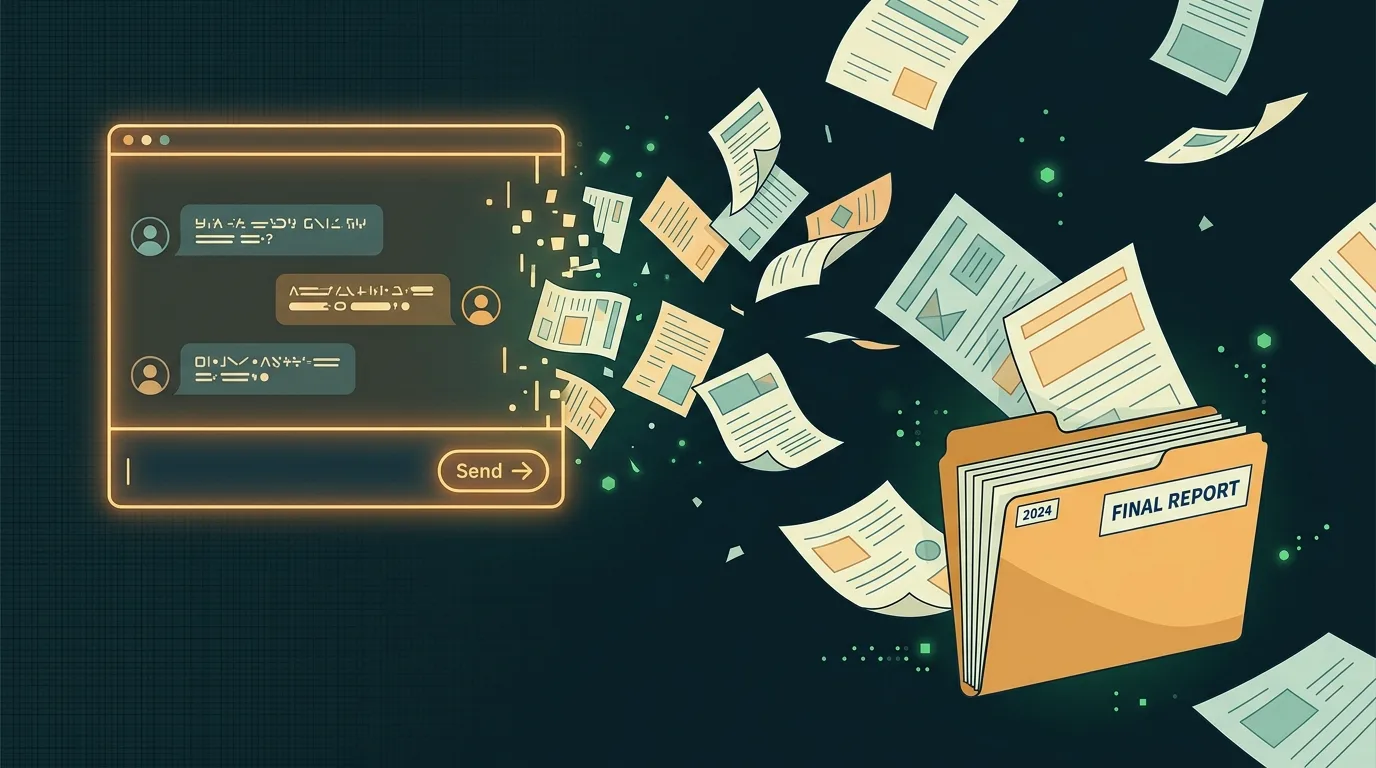
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:dev.to
说明文档里通常不写的取舍
写入放大与状态重复
每一个持久化的代理工作区,都在重复文件系统本已知道的东西。目录树存放文件,工作区存放一套关于这些文件的平行叙事。一旦两者分叉——有人在代理之外直接改了文件,或者一次重命名绕过了工具——工作区就会「自信地出错」,这比沉默地出错更糟。
缓解手段一半是工具问题,一半是纪律问题。团队需要一条规则来说明「人类直接编辑产物」时会发生什么,而诚实的答案通常是:工作区必须被作废或对账,并且必须有人负责这一步。
工作区泛滥
本地工作区会累积。让开启任务变得廉价的 CLI,也会让开启四十个任务变得廉价,其中大多数只产出一个产物就死掉了。没有保留策略——按天归档、折叠已完成任务、清理孤立工作区——存储就会变成墓地,消耗磁盘,更消耗注意力。
信任边界向内移动
一个拥有文件系统访问权的 MCP 服务器,本质上是一次能力授予。它读取来源素材、写入输出,并且是代表一个可能被所吸收内容说服的模型来做这些事。通过文档实施的提示词注入是已知失效模式;而一个刻意吞入文档的工作区,天然是放大器。目录作用域限制、显式白名单、拒绝执行任务内容里出现的指令,这些不是可选的加固项,而是「让模型长出双手」必须支付的价格。
仪式感与速度
每一层记录都会给快路径收税。基于聊天做文件工作之所以流行,正因为它毫无摩擦:提问、拿到、走人。Retulo 要求开任务、记决策、声明检查。对一个一次性脚本而言,这是纯开销。只有当工作的生命周期以天计、复核流程以人计的时候,这套工具才回本。
谁真正受益
高度契合: 运行多会话交付物的工程师——迁移、审计、生成的文档集、带分阶段评审的数据管线——同一份产物在不同日子被不同代理触碰。同样契合那些需要为「代理产出了什么、验证了什么」留下可辩护记录的团队,因为工作区是本地且可检视的,而不是被困在厂商的历史记录里。
不太契合: 单人一次性生成、探索性原型,以及任何产物本身就是消耗品的场景。给出一次性的工作加上繁文缛节,正是团队得出「代理工具太官僚」结论、然后回去从聊天里复制粘贴的原因。
确实存疑: 受监管环境。本地的、接近纯文本的状态对可审计性是真优势,但同一属性也意味着工作区可能含有敏感来源素材,而访问控制只取决于文件系统——通常等于没有。
值得点名的风险
- 两个事实源。 如果工作区与文件不一致,代理会相信工作区。请在你需要它之前就设计好对账路径。
- 过期检查被读成绿色通过。 三个版本之前记录为「通过」的检查,如果不与具体输出版本绑定,就是隐患。
- Schema 锁定。 MCP 标准化的是传输层,不是语义层。以后迁移自定义记录格式是实打实的工作量。
- 对完成的虚假信心。 结构化状态可能让团队「感觉」被审计过,实际并没有。记录的质量取决于其背后的强制执行力度。
一个理性的试点方案
挑一个周期两周、有两名评审人的重复性交付物。在 Retulo 里跑,并遵守三条规则:检查项绑定到具体输出版本;任何人对产物的手工编辑都会作废工作区;已完成任务每周归档。如果工作区被查阅的频率高于聊天记录,它就挣到了自己的位置;如果没人打开它,你用比全面铺开更低的成本学到了结论。
关键要点
- Retulo 瞄准的是真实缺口:代理很会产出文件,却很不会记住文件,而聊天记录无法替代结构化的任务状态。
- 以任务为锚点,配合版本、决策、未完成工作与检查项,是正确的粒度——再细就成噪音,再粗就失控。
- MCP 让存储与代理解耦,这是持久的收益,也是 schema 锁定风险的来源。
- 最大的运维风险是工作区与文件系统分叉、缺乏保留策略导致的泛滥,以及吞入不可信文档带来的提示词注入暴露。
- 对一次性工作是开销,对带复核环节的多会话交付物是杠杆。
下一步
- 复盘过去一个月的代理会话,统计有多少次需要从聊天记录重建上下文。这个数字就是你的预算依据。
- 只在一个多会话交付物上试用 Retulo,并显式把检查项绑定到输出版本。
- 在第一个任务开始之前——而不是第一次冲突之后——就定义好「人类编辑代理产物」的对账规则。
- 把 MCP 服务器限制在专用目录内,并把每一份被吞入的文档都视为不可信输入。
- 第一天就设好保留策略:归档节奏与孤立清理。因为以后你不会再补上它。
来源
- Retulo:面向代理文件工作区的 MIT 许可 Python CLI 与 MCP 服务器:https://dev.to/thestack_ai/retulo-keep-codex-and-claude-code-file-work-across-chats-1mje