AI 安全
对齐式网络安全智能体:AI 漏洞发现工具栈盘点
一个经过网络安全专项训练的前沿模型——既能发现可被利用的漏洞,又能给出修复方案,并且被训练为始终停留在授权范围内——它的意义并不在跑分榜上,而在于它释放的信号:安全工具正在往哪里走。应用安全领域真正的瓶颈从来不是检测能力,而是信任:团队能否把机器指向自己的系统、放手让它行动,并且仍然能为它的每一个动作辩护。
本文盘点值得采购的类别、值得自建的类别,以及区分「演示」与「上线」的那些关键问题。
为什么「授权范围」才是真正的产品线
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:openai.com
一个产出的告警远超团队处理能力的检测器,会让组织更不安全,而不是更安全——它掩埋了真正的信号,也透支了安全预算的可信度。真正改变成本结构的,是一个能被指向明确目标、能证明自己没有越界、并且顺手交回可复现修复的智能体。
这就重写了采购标准:范围清单、逐动作审计日志、可回滚性,比排行榜分数重要得多。对分布式与跨境工程团队而言尤其如此——智能体的操作日志会成为你交给审计方或客户安全问卷的合规证据。如果供应商无法导出「智能体碰过什么、为什么碰」的记录,那你买到的是一份包装精美的负债。
逐层拆解这套工具栈
模型原生安全智能体
最新的一层,也是当前关注度的来源。这类通用推理模型经过了安全领域训练:它们能同时阅读代码、配置、依赖图和 HTTP 流量,把零散观察串成一条攻击路径,并写出补丁。它们真正的优势是解释力——一段凌晨两点的中级开发也能看懂的叙述。
它们的失败模式同样鲜明:会在可达性上产生幻觉,把一个从未被调用的死代码当作可利用入口;在缺少监督时会对线上系统过度探测;对业务逻辑则自信地给出错误结论,因为业务逻辑并不是一种模式。
适用场景是你可控的环境:预发布镜像、归属清晰的代码仓库,以及一个真的看得懂补丁 diff 的评审人。
静态分析引擎
CodeQL、Semgrep 这类规则引擎,仍然是获得确定性、可复现、可解释结果的最便宜路径。它们不会幻觉。它们也不会思考——规则需要有人编写和维护,而这部分维护才是隐藏的账单。
有效的模式是配对而非替代:引擎批量产出高置信度候选,智能体补充上下文并起草修复,人类批准。
可达性分析与应用安全态势层
这是整套栈中被采购得最少的一类。能回答「这个 CVE 在我们的构建里到底可达吗」的工具,消灭的工作量比任何检测器增加的工作量都多。多数安全待办清单被大量「在该部署中从未可被利用」的问题占据。
在此之上叠加智能体层,可以推理调用路径与运行时配置;但在你决定给任何问题降级之前,先用确定性的可达性引擎验证它的说法。
模糊测试与动态 harness
在内存安全类缺陷上,覆盖率引导的模糊测试依然无可替代,而这是智能体辅助而非取代的一层。有价值的贡献是生成 harness 与归并崩溃:写下没人愿意写的驱动代码,再把数千次崩溃聚类成少数几个根因。
人工主导的评估与漏洞赏金
智能体的产出应当用于为人工作战团队提供范围界定与假设生成,而不是替代他们的判断。授权决定本身始终由人来做——这是唯一不该交给模型的判断。
什么时候该用,什么时候不该用
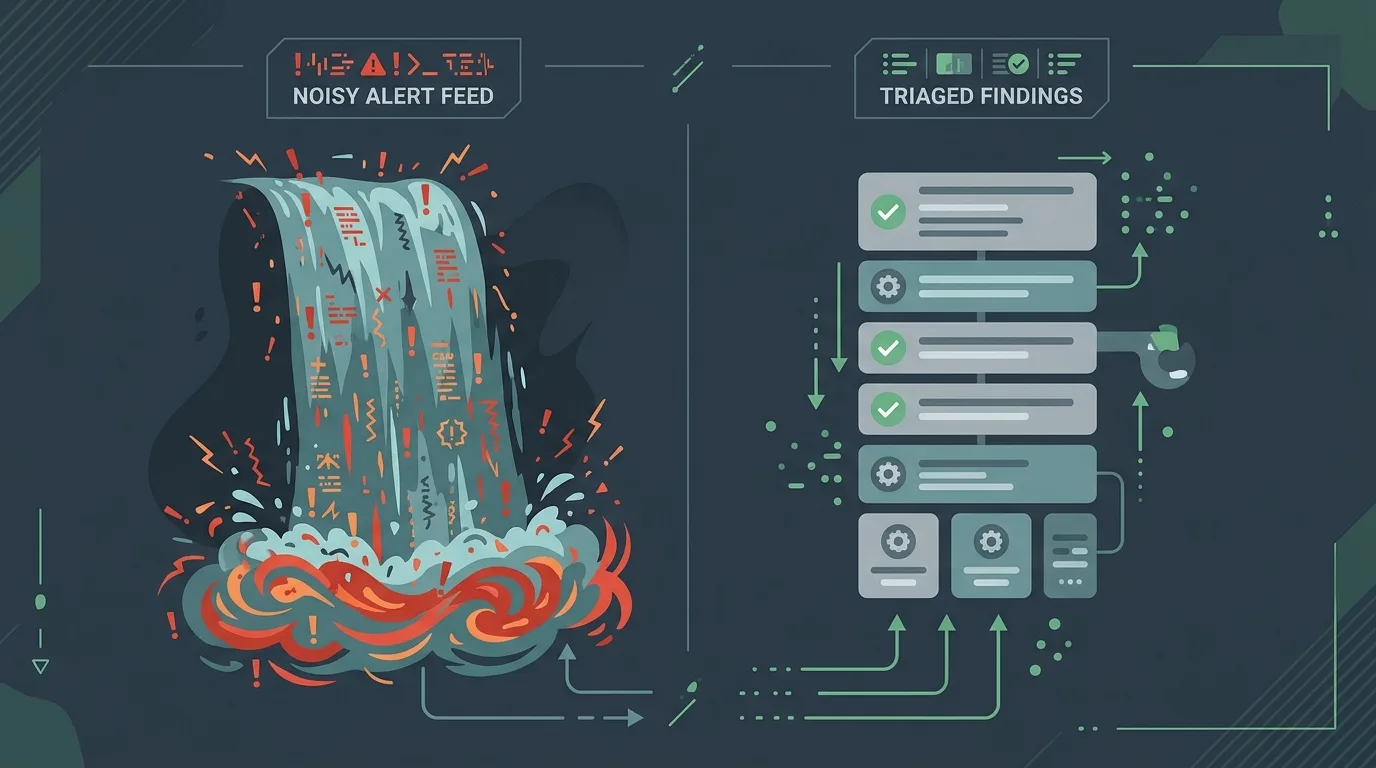
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:openai.com
**合理场景:**规模庞大、年代久远且测试覆盖率低的代码库;对完全自有代码做并购前或审计前扫描;为注入、反序列化、路径穿越等成熟缺陷类别生成补丁;以及告警归并压缩——智能体的任务是把一万条告警压缩成两百条人类真正该看的。
**不适合的场景:**任何你不拥有、或没有书面授权测试的系统——这正是范围训练存在的意义,越界是法律事件,不是 bug;受监管的生产环境,那里一个具备网络出口的智能体本身就成了新的攻击面;威胁建模,它需要的是判断业务输不起什么,而不是什么看起来像模式;以及被生成代码和第三方依赖主导、又未做严格过滤的代码库——信噪比会崩塌,智能体开始把框架本身当成漏洞报给你。
定价注意事项
- 企业级安全模型是报价制,不是标价制。 通常是年度合同,按席位或按扫描次数计费,且设有假定你已有安全团队的价格下限。务必明确询问续约时会发生什么。
- 智能体式扫描的算力消耗与仓库规模和推理深度成正比。 限制了推理步数的档位在演示里很好看,在生产里很单薄。请估算「一次全仓库扫描」的成本,而不是「每月」的成本。
- 静态引擎按开发者席位或代码行数定价,看起来很便宜——直到你算上维护自定义规则投入的工程师工时。那才是真实账单。
- 云厂商或 CI 厂商附赠的额度会掩盖第二年的价格台阶。永远按续约价建模,而不是首年折扣价。
- 开源引擎加自建编排是现金成本最低、人力成本最高的路径。诚实地评估你手上更富余的是哪一种资源。
- 免费档位的存在自有其理由。 它们是获客漏斗。请确认审计日志、范围控制与导出这些「让工具站得住脚」的功能是否被锁在付费档——通常都是。
上线前必须要求的护栏
- 书面的范围清单:目标列表、时间窗口、明确排除的主机。
- 逐动作授权日志,能以审计方接受的格式导出。
- 干跑模式:只产出结论,不发起主动探测。
- 补丁以 diff 形式提交,绝不自动合入受保护分支。
- 一键停止开关与出口白名单。
- 每次任务指定一名人类批准人,并赋予其叫停权。
关键要点
- 让 AI 安全智能体真正可部署的,是范围纪律与可审计性,而不是检测数量。
- 把模型原生智能体与确定性的静态分析、可达性引擎配对:智能体负责解释与修复,引擎负责证明。
- 绝不要把自主智能体指向你没有书面授权测试的基础设施。
- 按第二年预算,按单次全仓库扫描计价,并把规则维护悄悄吃掉的工程师工时计入。
- 授权决定与合并按钮,始终留在人类手上。
下一步
挑选一个自有仓库并配好预发布镜像,做一次限时试点:先跑静态扫描建立基线,再让智能体以干跑模式跑一轮,最后走一个完整的补丁审批周期。记录有多少结论通过了人工复核——这个比例,而不是供应商的跑分,才是你的商业论证。