GEO
AI 智能体可以运行 shell 命令、修改文件并提交结果。但它无法点击 Godot 编辑器里的按钮。因此,当任务是把游戏置入某个状态——progress/stage = 7、tutorial_done = true、audio/master = 0.42——智能体会直接编辑存档文件。编辑器可以通过停靠面板完成同样的事,但终端看不到那个面板。这不是 Godot 独有的问题,而是机器优先的问题,也正是你的网站现在面临的问题。
存档文件问题是机器优先问题
图示:来源页预览图(仅作编辑上下文;版权归属原发布方) · 来源引用:dev.to
最直接的做法是 json.load → 改一个值 → json.dump。在真实的 Godot 存档上,这会悄悄改变你并未要求改变的数据。数字可能以不同方式往返。键顺序可能变化。Unicode 转义可能被重写。默认值、隐藏字段和类型期望可能丢失。编辑器之所以能保留不变量,是因为它理解 schema;通用 JSON 工具则不然。
这就是 GEO 的核心教训:当 AI 智能体消费你的内容时,它并不是在浏览你的 UI。它读取的是一种原始表示,并试图在不知道你有哪些不变量的情况下保留你的含义。如果你的页面依赖布局、客户端状态、标签页、悬停文本或隐式默认值,机器看到的文档就与人类访客不同。问题不是智能体会不会解析你,而是解析之后还剩下什么。
为什么这对搜索与 GEO 重要
传统 SEO 问的是爬虫能否抓取、渲染并索引页面。GEO 问的是更难的问题:模型能否提取稳定事实、正确归属,并在不扭曲来源的情况下引用?智能体不会点击。它们抓取 HTML、剥离标签、切分文本、调用工具并综合。除非你为此设计,否则每一步都是有损转换。
AI 阅读你的网站时,什么会坏掉
- 类型与数字。 价格、日期、版本、评分和数量常常变成字符串或浮点数。页面写
$19.00,可能被引成19或1900。结构化数据能减少这种歧义。 - 结构。 标题、列表和表格会塌缩成纯文本。对比表变成一段话,列与列之间的关系消失。
- 状态。 藏在 JavaScript、cookie、地理定位或 A/B 测试后面的内容,可能永远不会出现在抓取到的表示里。如果事实只在点击后存在,智能体可能永远看不到。
- 身份。 规范 URL、slug、产品名和实体标识在不同页面间漂移。智能体只能引用它能解析的内容,模糊身份会产生模糊引用。
- 来源。 指向锚点、查询字符串和会话专属 URL 的深链并不稳定。指向昨天 A/B 变体的引用不是可审计的引用。
结构化内容是那层不变量
在 Godot 故事里,编辑器保留 schema,是因为它理解文件。在 Web 上,最接近的等价物是结构化内容:服务端渲染的 HTML、schema.org 与 JSON-LD、稳定 ID、显式日期、规范 URL,以及干净的 markdown 镜像。这些不是给富媒体摘要做装饰,而是让机器在不猜测的情况下重建你含义的不变量。
一个实用测试是把页面当纯文本看。如果事实消失了,智能体就找不到。如果事实还在但关系消失,智能体可能误引。如果事实连同来源和日期一起保留,你才有了可引用的东西。
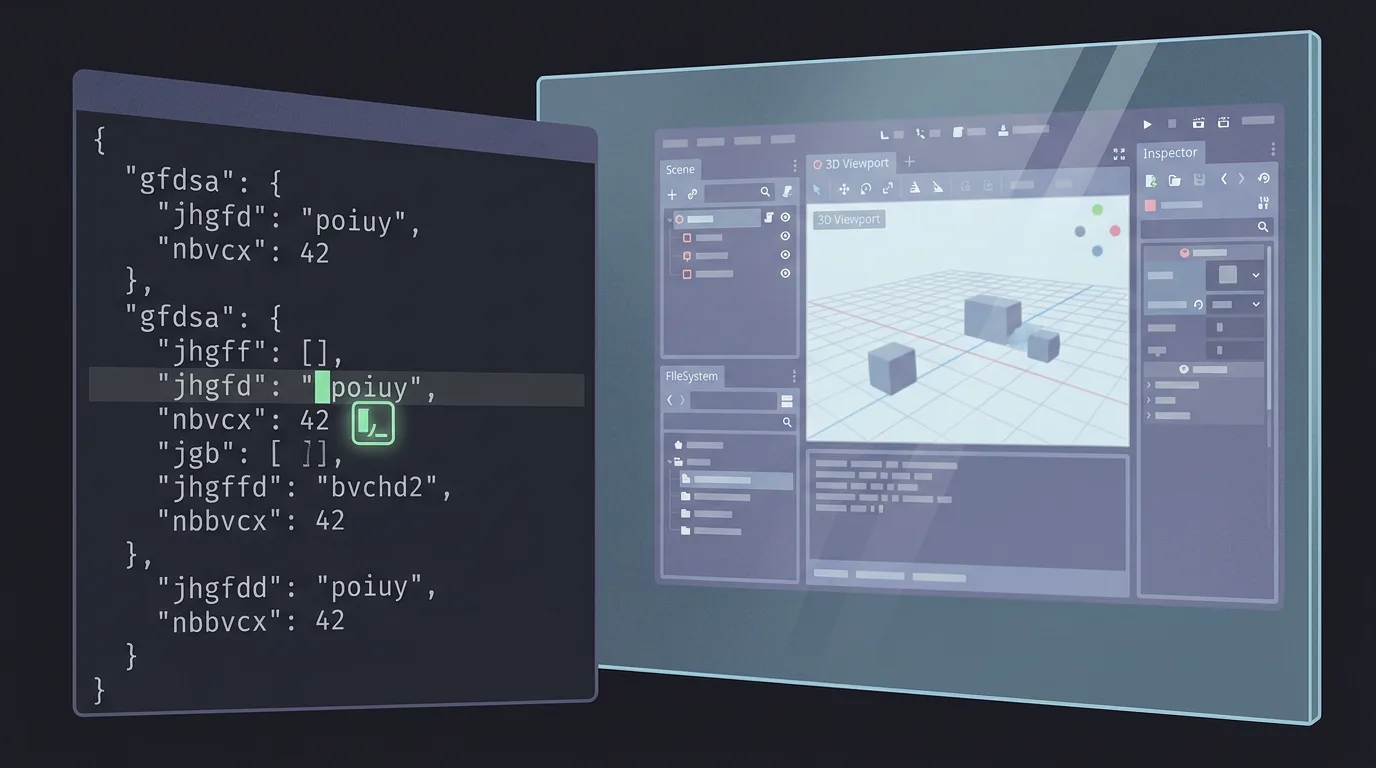
图示:HEXOPS 原创配图(受选题启发,非复制原文图片) · 来源引用:dev.to
llms.txt 是码头,不是存档文件
llms.txt 有用,因为它给模型一张明确的地图:哪些页面重要、摘要是什么、首选入口在哪里、许可如何。但它是码头,不是存档文件。它不能替代结构良好的页面,也无法补偿只在客户端渲染后才出现的内容。把它当作需要维护的索引:版本化,URL 变化时复查,确保每一行都指向稳定页面。
同样的逻辑适用于 sitemap、RSS、OpenGraph 和内容协商。每一项都是机器可读的承诺。如果承诺与页面漂移,智能体会信任一种表示,却引用另一种。
AI 引用奖励稳定、可提取的事实
模型会引用它能自信提取的内容。这有利于拥有清晰标题、简短陈述句、具名来源、发布日期和规范 URL 的页面。它不利于把关键事实埋在视频里、锁在反爬墙后、或拆成十张幻灯片的页面。
这不是说要为机器人写作,而是说写作要让人类含义在机器提取后仍然存活。像“根据 2024 年报告,采用率同比增长 18%”这样的句子既可读又可引用。而同一个数字只在三层筛选后才出现的仪表盘,两者都做不到。
为智能体设计,同时不破坏人类体验
你不需要一个只给智能体看的独立网站。你需要一个事实来源,配以多种忠实表示:给浏览器的 HTML、给解析器的结构化数据、给检索的 markdown、给定位的 llms.txt。机器人访问要有意设计——屏蔽 AI 爬虫可能保护内容,但也把你从引用层移除。衡量智能体实际抓取什么,而不只是浏览器渲染什么。
关键要点
- 智能体消费原始表示,而不是你的 UI。结构就是 API。
- 保留不变量:规范 ID、类型、日期、来源和稳定锚点。
- 把
llms.txt当作地图,而不是结构化页面的替代品。 - 用清晰标题、来源和日期让事实可提取、可引用。
- 用纯文本和智能体视角测试网站,而不只是浏览器视角。
下一步
- 把五个关键页面当纯文本审计,记录哪些事实消失。
- 为每个应被引用的页面添加 JSON-LD 和规范 URL。
- 发布经过复查的
llms.txt,并为核心内容提供 markdown 镜像。 - 明确决定 AI 爬虫策略并形成文档。
- 跟踪 AI 引用,修复归属不稳定的页面。